- Enjeu
- Sanofi engage sa transformation Industry 4.0 sur ses opérations manufacturing. Une data foundation existe — des volumes importants de données industrielles sont collectées en continu sur les lignes de production. Mais ces données, bien que présentes, restent en silo. Non contextualisées. Non connectées aux réalités métier. Impossibles à mobiliser pour de l'IA, de la prédiction ou de la simulation industrielle.
- Méthode
- Trois chantiers imbriqués. Une logique de valeur progressive.
- Livré
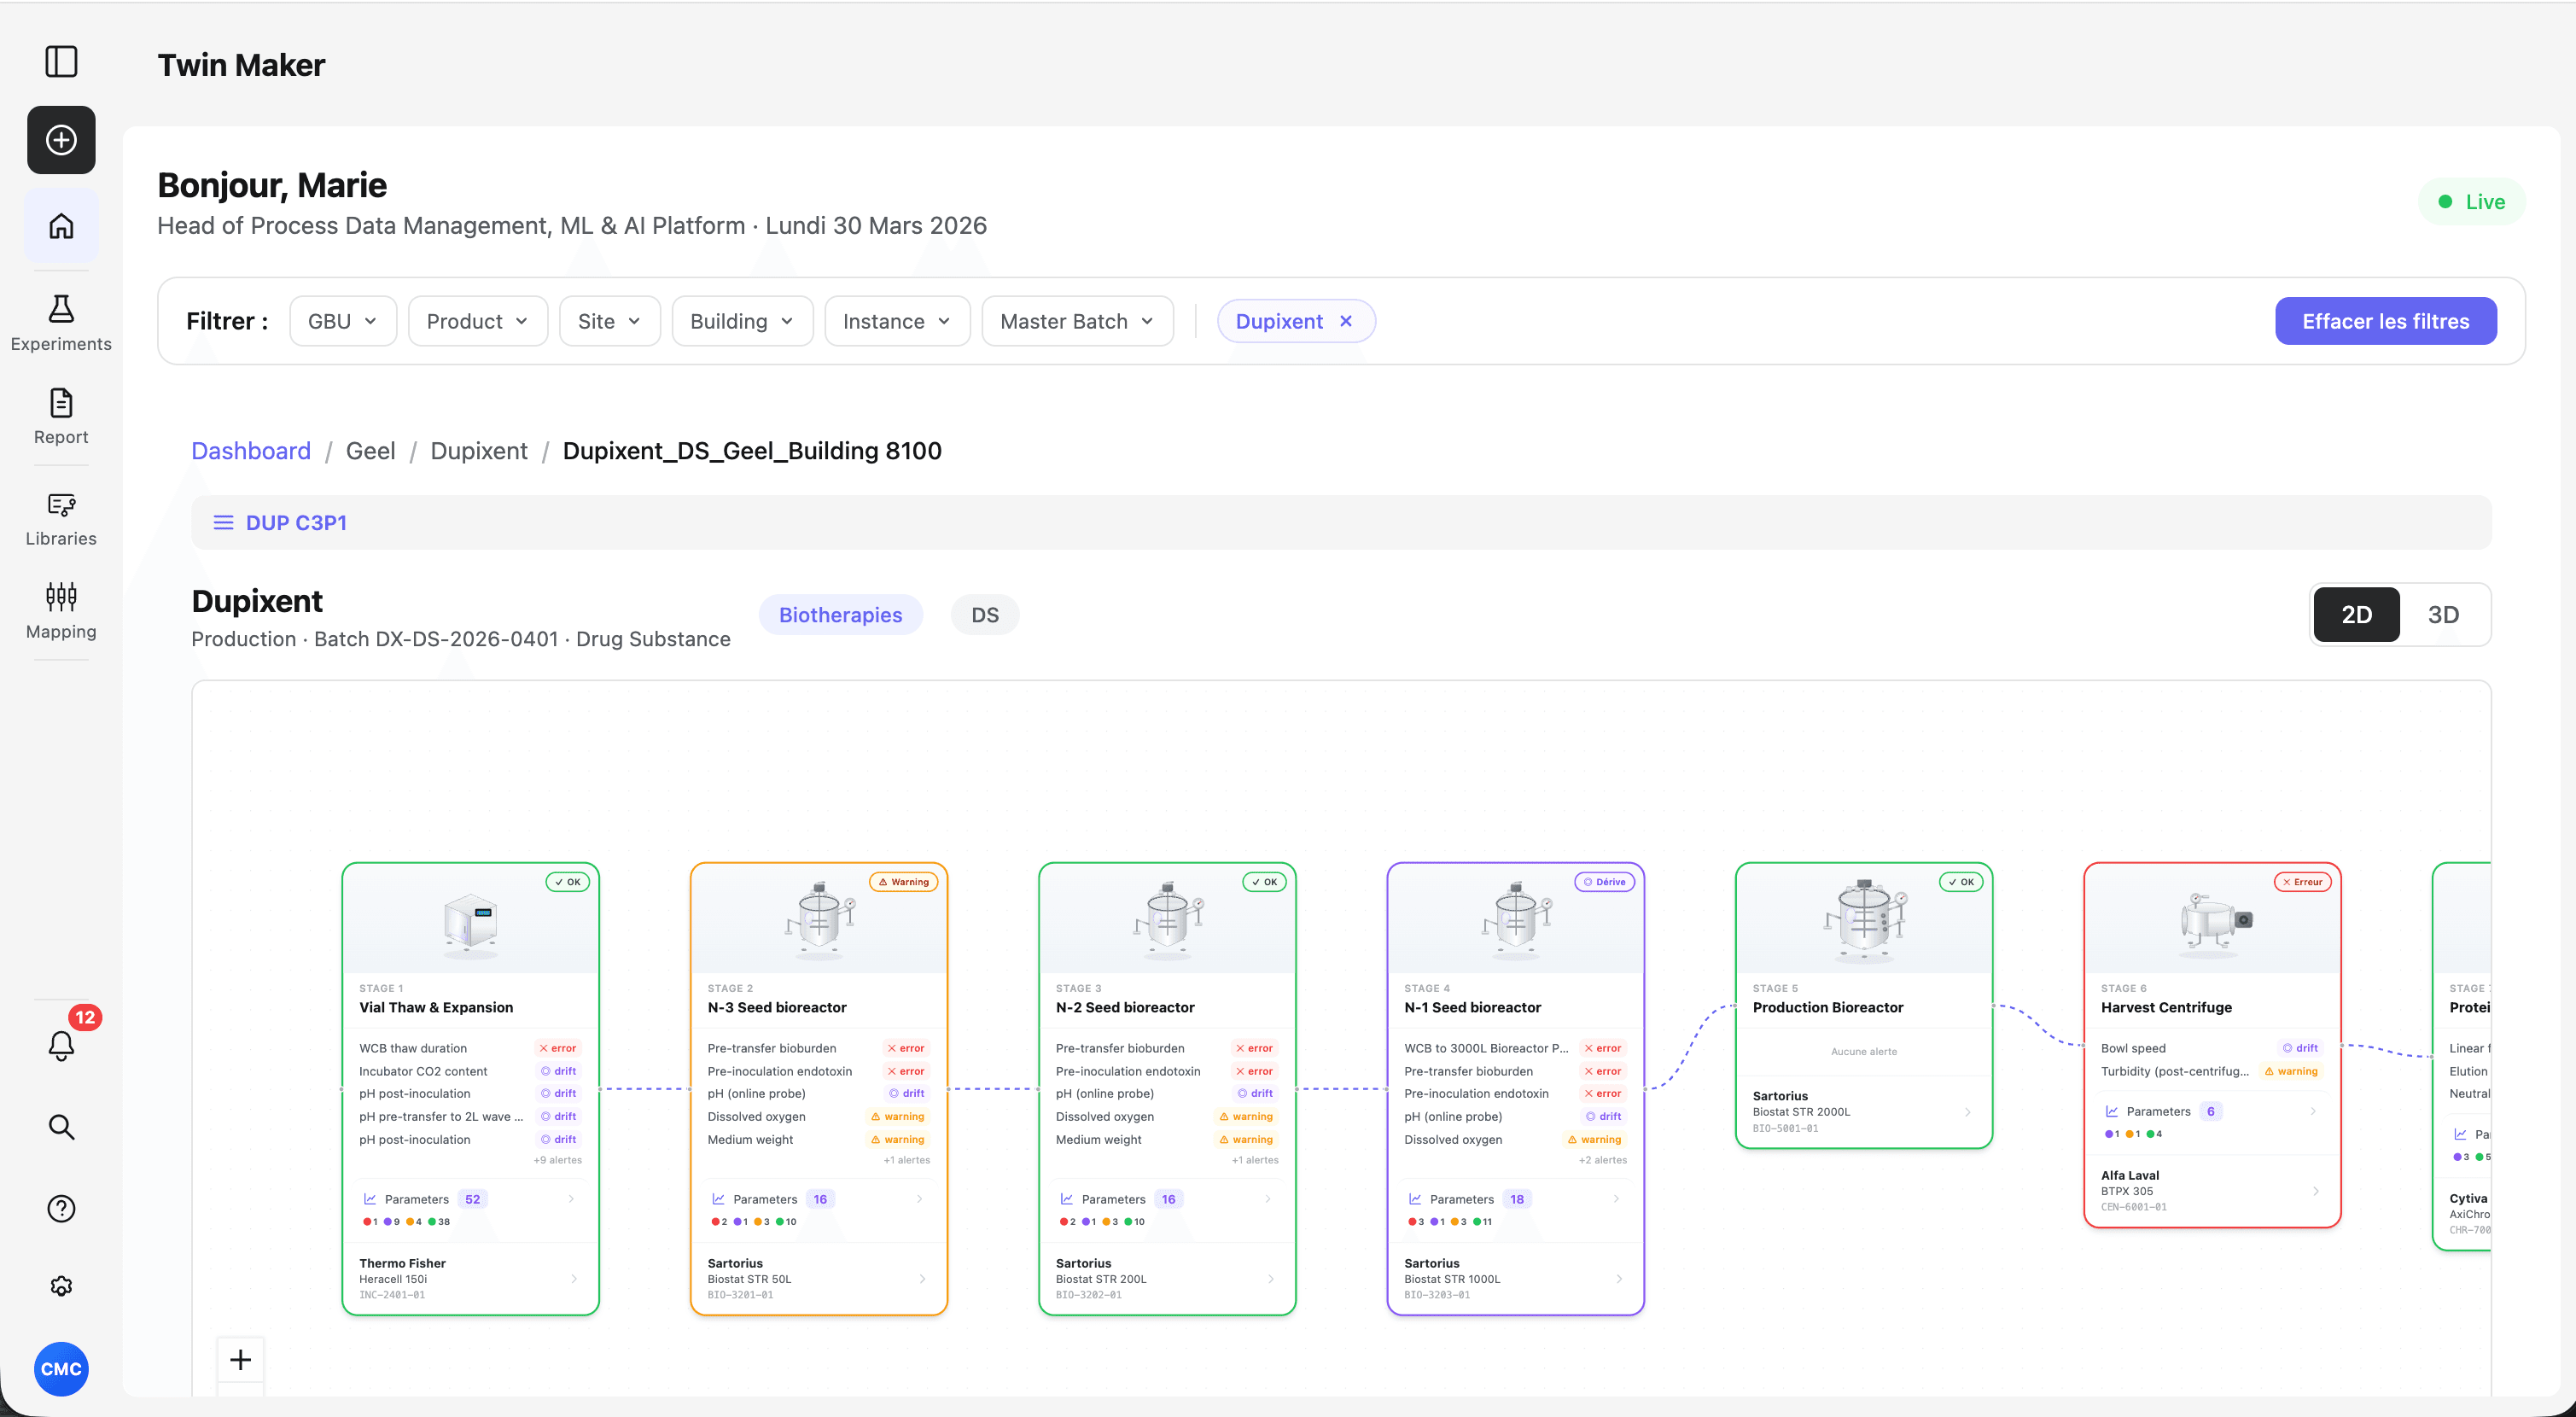
- Digital shadow manufacturing opérationnel sur le site pilote — représentation temps réel de l'état des opérations, validée par tests utilisateurs. Trajectoire définie vers 3 sites.
Sanofi engage sa transformation Industry 4.0 sur ses opérations manufacturing. Une data foundation existe — des volumes importants de données industrielles sont collectées en continu sur les lignes de production. Mais ces données, bien que présentes, restent en silo. Non contextualisées. Non connectées aux réalités métier. Impossibles à mobiliser pour de l'IA, de la prédiction ou de la simulation industrielle.
Le mandat confié : transformer cette masse de données brutes en actif stratégique, poser les bases d'un digital shadow opérationnel — et mener la discovery d'un digital twin pour les équipes manufacturing et supply chain.
Les équipes data avaient des données. Les équipes terrain avaient des problèmes. Les deux ne se parlaient pas.
Sans contextualisation métier — par site, par ligne, par équipement, par batch — les données restaient orphelines de sens. Impossibles à connecter à un cas d'usage IA. Impossibles à simuler. Et les équipes manufacturing continuaient à piloter à l'instinct, sans levier prédictif, sans vision consolidée de la performance.
Le risque réel : investir massivement dans un digital twin sans fondations solides — et livrer une couche technologique sophistiquée que personne n'utilise parce que personne n'a été impliqué dans sa conception.
Trois chantiers imbriqués. Une logique de valeur progressive.
Étape 1 — Valorisation de la data foundation
Définition de la taxonomie industrielle : contextualisation des données par site de production, équipement, produit, batch. Travail avec les équipes data et manufacturing pour relier les données existantes aux cas d'usage métier — et les rendre lisibles pour des modèles d'IA.
Étape 2 — Cadrage du digital shadow (1 site pilote, 3 en cible)
Première couche du jumeau numérique : représentation en temps réel de l'état des opérations à partir de la data foundation contextualisée. Définition du périmètre, des flux de données, et des indicateurs clés. Démarrage sur un site pilote, avec une trajectoire définie vers 3 sites.
Étape 3 — Discovery du digital twin (3 → 15 personas, 4 cas d'usage IA priorisés)
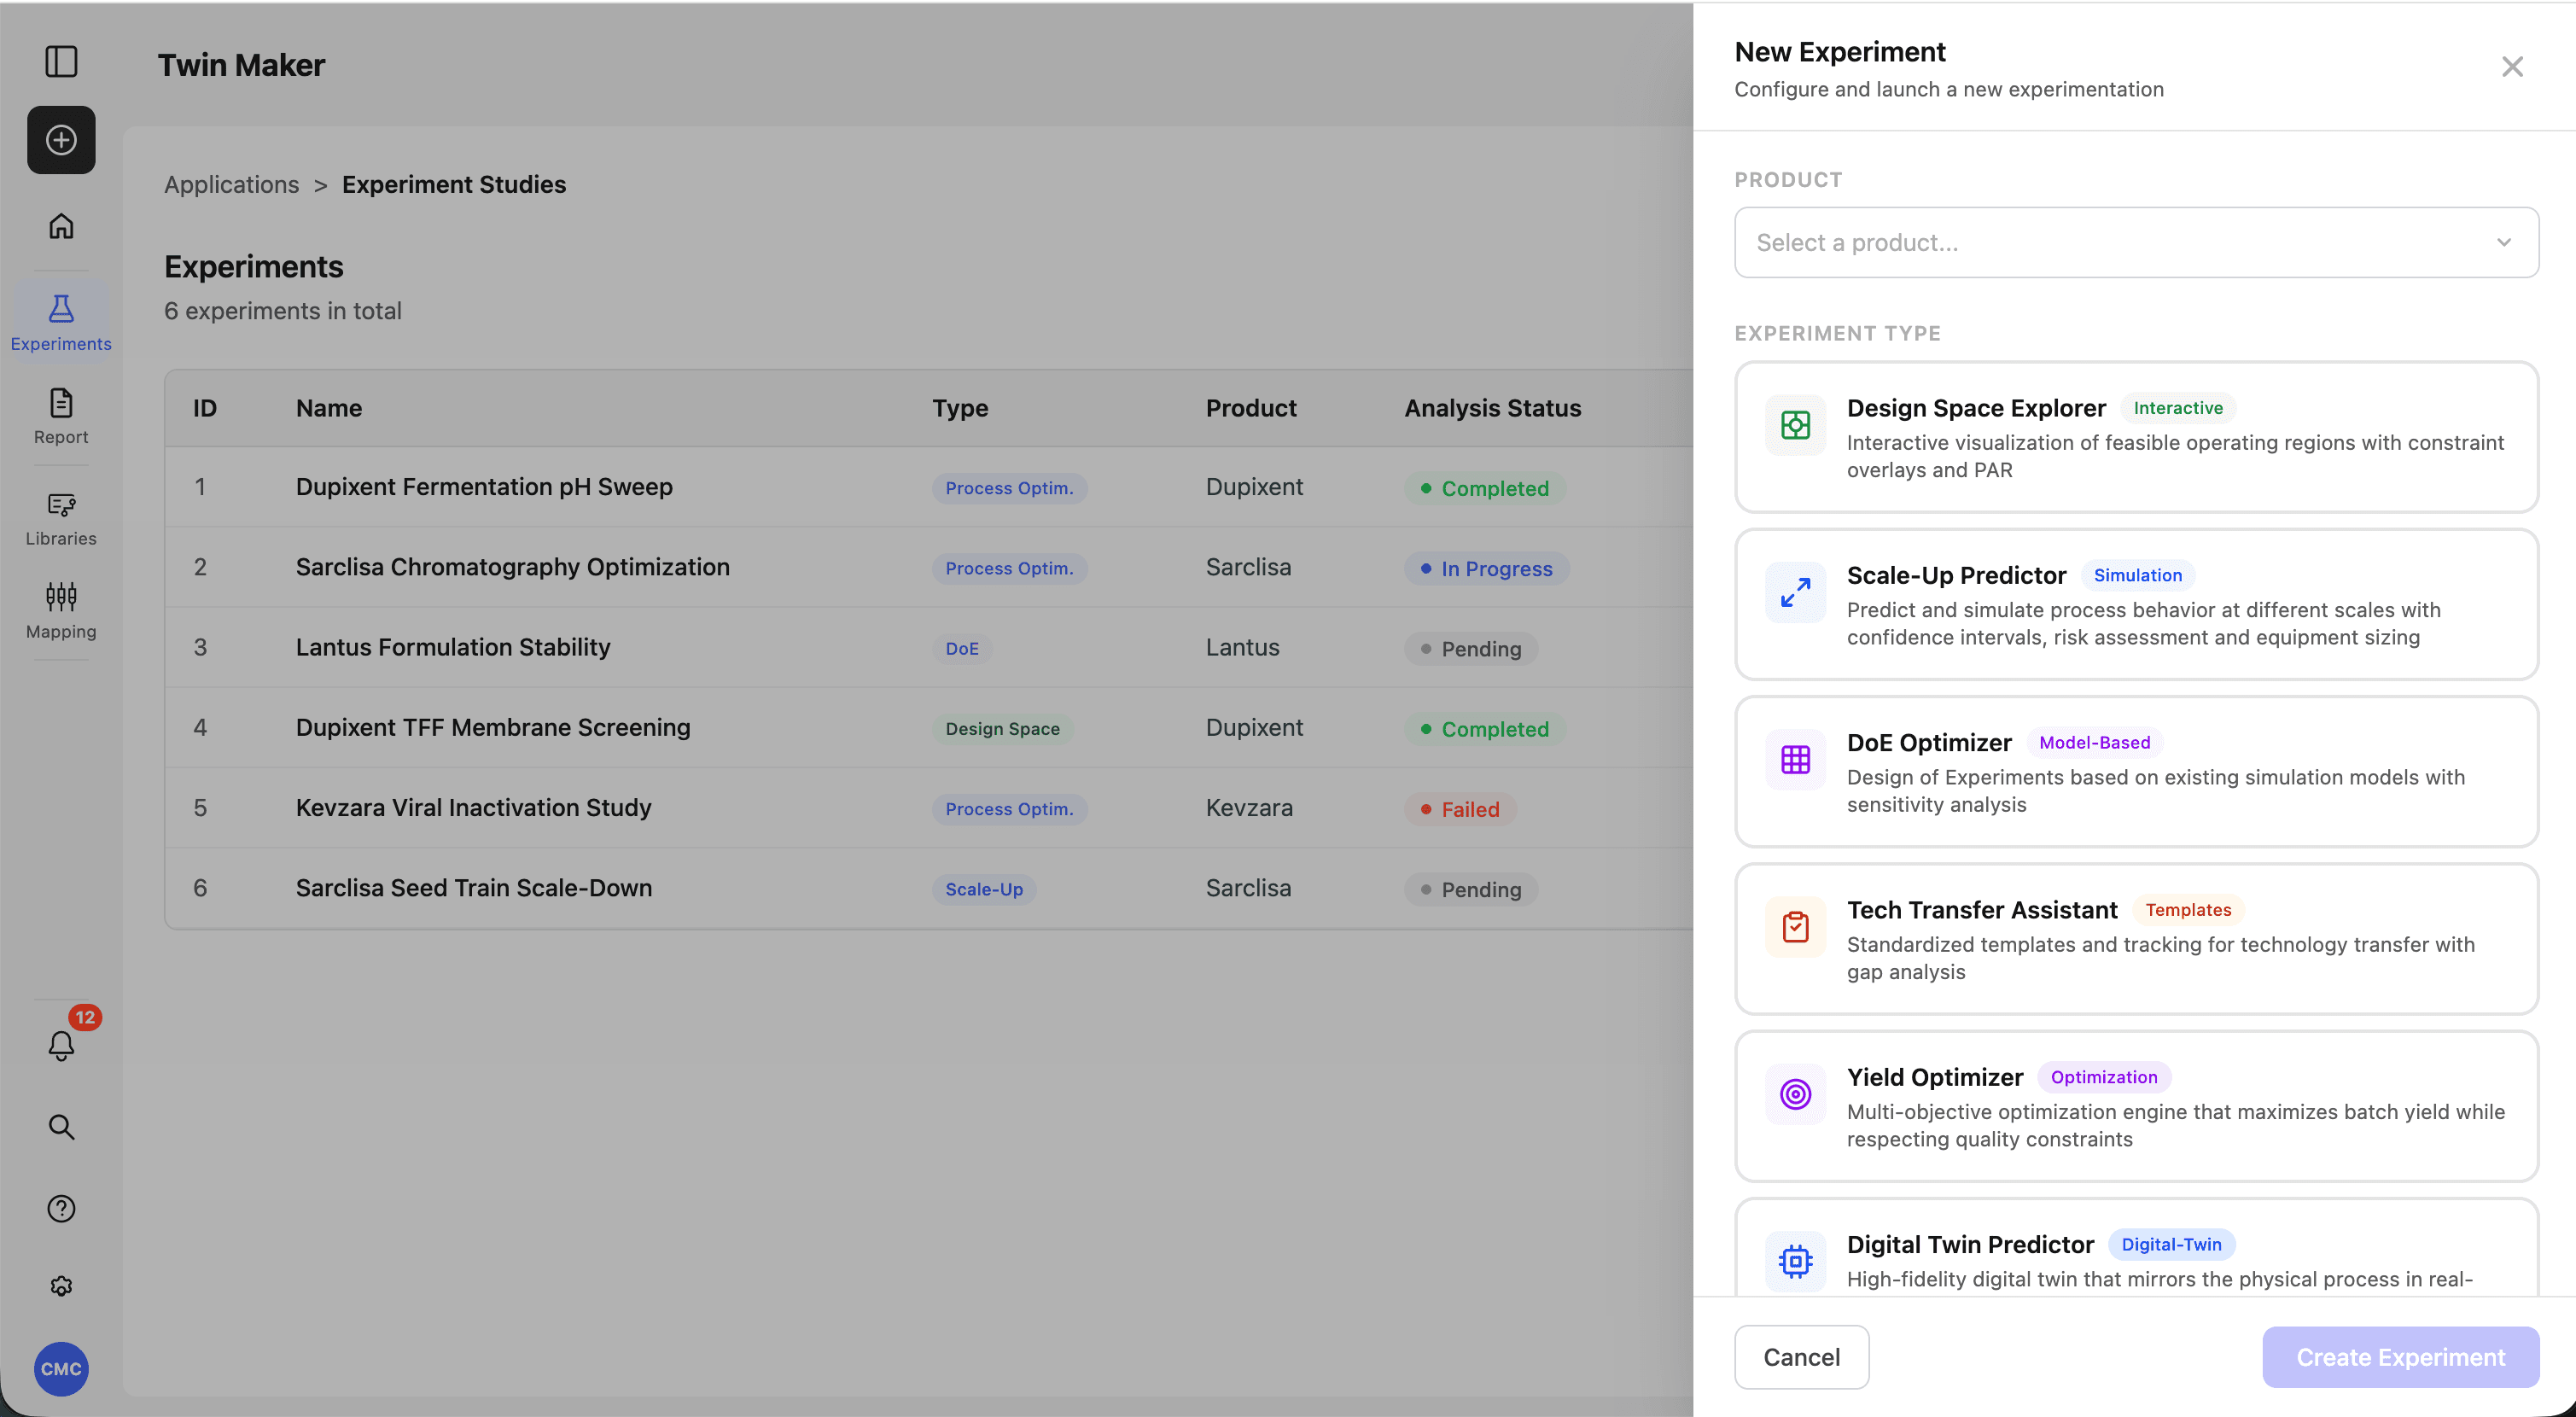
Interviews utilisateurs avec les équipes production, supply chain et data. Élargissement progressif du périmètre de recherche : de 3 personas clés à 15 profils identifiés. Formalisation des pain points, problem statements et cas d'usage. Priorisation de 4 cas d'usage IA en POD — dont Batch Performance et Launch Readiness.
Pas de solution avant le problème.
La tentation sur ce type de projet : partir de la technologie et chercher ensuite à qui elle sert. C'est l'inverse que j'ai imposé.
Avant de modéliser quoi que ce soit, j'ai passé du temps sur le terrain — avec les opérateurs de ligne, les managers supply chain, les équipes data — pour comprendre ce qui créait vraiment de la friction. Quelles décisions étaient prises à l'instinct faute de données fiables. Quels processus consommaient du temps sans générer de valeur.
Les ateliers de discovery ont permis de confronter les ambitions technologiques aux réalités terrain, et d'arbitrer ce qui crée de la valeur versus ce qui crée de la complexité — avant d'engager des ressources de développement.
- 4 cas d'usage IA priorisés en POD — dont Batch Performance et Launch Readiness
- Digital Shadow opérationnel sur le site pilote — trajectoire définie vers 3 sites
- 15 personas identifiés sur le périmètre manufacturing et supply chain (vs 3 au démarrage)
- Data foundation contextualisée — données industrielles prêtes pour des modèles IA
- Backlog discovery structuré — orienté valeur métier, prêt pour une phase de développement